Para leer apuntes con ayuda de un modelo descargado, LM Studio es un punto de partida razonable por su chat con documentos. Si quieres conectar el modelo a otra aplicación, comprueba antes qué integración admite: Ollama puede encajar, pero LM Studio también tiene servidor y API. Elegir solo por la etiqueta «interfaz frente a terminal» deja fuera funciones de ambos.
Esta comparación se dirige a usuarios particulares en España y se basa en documentación oficial consultada el 18 de octubre de 2026. No hemos probado los programas ni medido velocidad, consumo o calidad de respuesta. No comparamos tarifas de nube: el objetivo es decidir cómo usar un modelo en tu ordenador.
Tabla de decisión: qué cambia en tu uso
| Tu decisión | Ollama | LM Studio | Qué conviene comprobar |
|---|---|---|---|
| Empezar a conversar | La guía contempla aplicación y terminal. | Ofrece chat con modelos descargados y documentos en la aplicación. | Prueba el recorrido que usarás cada día; ninguno se limita a una sola interfaz. |
| Conectar otra aplicación | Ofrece API local y guías de integración. | Ofrece API local, SDK y endpoints compatibles con otros servicios. | Busca soporte para el proveedor, endpoint y función concretos de tu aplicación. |
| Automatizar desde terminal | La guía documenta descarga y ejecución mediante comandos. | Dispone de CLI lms y un daemon que puede funcionar sin la interfaz gráfica. |
Una interfaz visual no impide automatizar; decide por el flujo que necesitas. |
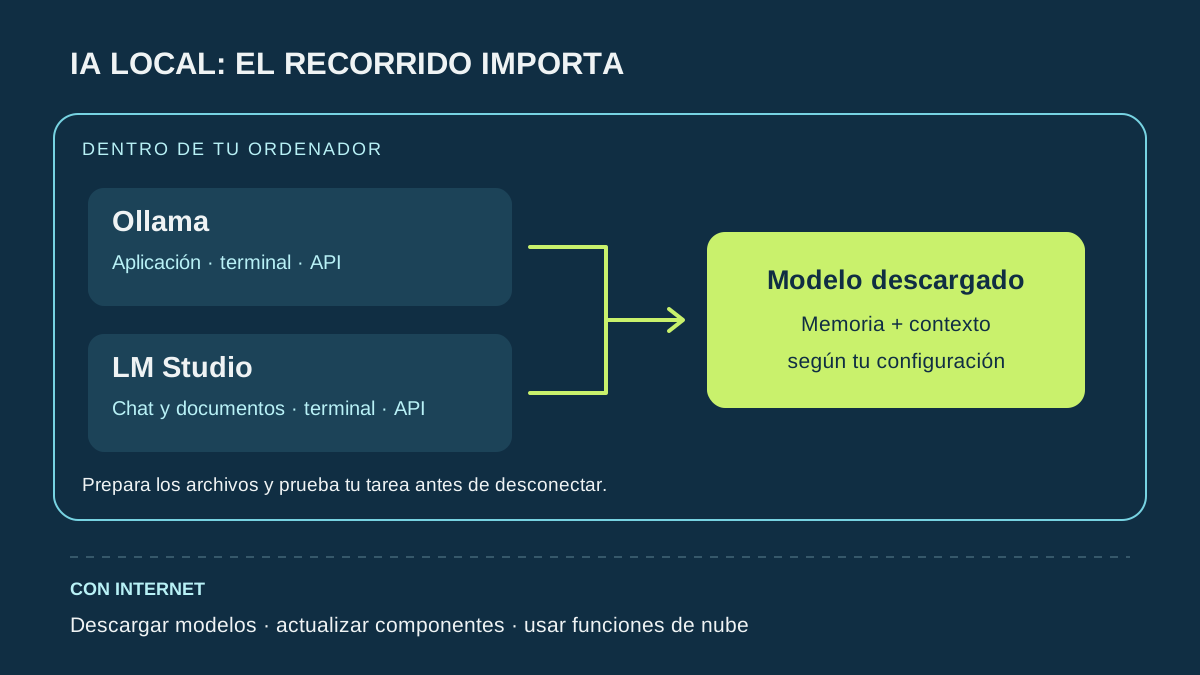
| Trabajar sin Internet | Selecciona un modelo local; permite desactivar las funciones de nube. | Chat, documentos y servidor pueden funcionar sin red tras preparar los archivos necesarios. | Descarga primero modelo y componentes; después ensaya la tarea sin conexión. |
| Elegir ordenador y modelo | El contexto y las solicitudes simultáneas afectan a la memoria requerida. | Publica requisitos por sistema y recomendaciones de memoria. | Que la aplicación abra no demuestra que el modelo elegido quepa o responda con comodidad. |
La guía de inicio de Ollama, su FAQ y la documentación para desarrollar con LM Studio respaldan las funciones de la tabla. El funcionamiento sin red y los requisitos de LM Studio se detallan en sus páginas de uso offline y sistema. La columna final es nuestro criterio editorial, no una clasificación de rendimiento.
«Local» depende del modelo y de las funciones que actives
Ollama permite elegir entre modelos locales y de nube. Su documentación distingue el tratamiento de las conversaciones: afirma que no ve tus prompts cuando ejecutas localmente; las solicitudes a modelos alojados en su nube sí se procesan en ese servicio. También documenta un modo solo local que desactiva modelos de nube y búsqueda web. Es una descripción del proveedor, no una auditoría independiente de privacidad.
LM Studio explica que el chat con un modelo descargado, el procesamiento de documentos y el servidor local pueden funcionar sin Internet. Buscar o descargar modelos, obtener motores de ejecución y comprobar actualizaciones sí requiere conexiones. Por tanto, poder conversar sin red no significa que la aplicación nunca intente conectarse mientras tienes Internet. Ambas distinciones proceden de la FAQ de Ollama y de Offline Operation de LM Studio.
Antes de introducir información sensible, revisa también las extensiones y herramientas que añadas al flujo. Nuestra recomendación es empezar con material no confidencial y verificar el recorrido completo. Instalar un ejecutor local no permite dar por comprobado el comportamiento de todos sus complementos.
API local: comprueba la función, no solo la marca compatible
Una API permite que otra aplicación envíe solicitudes al modelo. Ollama documenta solicitudes a su servidor local sin clave de su servicio de nube y avisa de que la compatibilidad con APIs de terceros cubre un subconjunto de las originales. LM Studio documenta endpoints locales compatibles, además de sus propios SDK y API REST. Consulta la guía de Ollama y el índice de desarrollo de LM Studio para el flujo concreto.
No presupongas que cambiar la dirección del servidor conserva todas las funciones de una aplicación. Comprueba si necesita conversación, documentos, herramientas o una salida estructurada, y si la combinación de modelo y ejecutor la admite. La compatibilidad del endpoint tampoco convierte el modelo descargado en el modelo del proveedor cuya API imita.
Si tu interés son tareas delegadas en un servicio, la comparativa de Dots y ChatGPT plantea una decisión distinta. Aquí elegimos cómo ejecutar y conectar un modelo local; no hemos demostrado que sustituya todas las capacidades de esos servicios.
Memoria: evita comprar equipo a partir de una cifra aislada
LM Studio recomienda al menos 16 GB de RAM para macOS y Windows en la documentación consultada. Para Mac exige Apple Silicon y macOS 14 o posterior; explica que algunos modelos pequeños con contextos modestos pueden utilizarse en equipos de 8 GB. En Windows x64 exige AVX2. Estas condiciones corresponden a su página de requisitos, no a una garantía para cualquier modelo ni a un mínimo universal de IA local.
Ollama explica que la ventana de contexto y las solicitudes simultáneas cambian las necesidades de memoria. El contexto es la cantidad de información que el modelo maneja en una solicitud; ampliarlo puede requerir más recursos. La FAQ también permite consultar si un modelo está cargado en GPU, CPU o ambas. Esa información ayuda a diagnosticar tu configuración, pero no aporta una comparación de velocidad entre estos dos programas.
Antes de cambiar de portátil, prueba una tarea representativa en el equipo que tienes. Apunta modelo y variante, tamaño del contexto, memoria disponible y tiempo de respuesta. Si comparas ejecutores, conserva esos parámetros tanto como permitan: de otro modo puedes estar comparando configuraciones diferentes.
Checklist: prepara una sesión sin conexión
Este es un procedimiento propuesto para tu equipo, no una prueba que hayamos ejecutado. Úsalo antes de depender de la aplicación durante un viaje o una clase sin red.
- Define una tarea pequeña. Por ejemplo, pedir un resumen de un texto no confidencial y hacer una pregunta cuya respuesta puedas comprobar.
- Prepara los archivos con conexión. Instala la aplicación y descarga el modelo; en LM Studio comprueba también el motor de ejecución necesario. Abre una conversación para confirmar que la preparación terminó.
- Comprueba el destino. En Ollama elige un modelo local y revisa su opción de desactivar la nube. Si conectas otra aplicación, confirma que apunta al servidor de tu propio ordenador.
- Desconecta la red y repite. Reinicia el recorrido que vas a necesitar y ejecuta la tarea. Si falla, anota qué componente pide conexión antes de darlo por preparado.
- Verifica el resultado. Contrasta el resumen con el original, comprueba si el tiempo te resulta aceptable y evita confundir una respuesta plausible con una respuesta correcta.
El criterio de aceptación es concreto: tu tarea, con ese modelo y esos archivos, funciona sin conexión y produce algo que puedes revisar. El resultado no demuestra que todas las funciones de la aplicación sean offline ni certifica su privacidad.
Un caso práctico para decidir sin cambiar de ordenador
Imagina que preparas un examen y quieres preguntar sobre tus apuntes durante un trayecto. Es un caso hipotético. LM Studio documenta procesamiento local de documentos, por lo que empezaríamos por comprobar ese flujo con un archivo pequeño. Descargaríamos modelo y componentes antes de salir y pasaríamos la checklist anterior; no damos por hecho que un documento largo quepa ni que el resumen sea correcto.
Si, en cambio, tu editor o aplicación habitual ya admite Ollama, comprobaríamos primero esa integración con un modelo local. Instalar ambos programas solo tiene sentido si resuelve una necesidad concreta de prueba o de uso. Si el que ya utilizas supera tu prueba y cubre la tarea, conservarlo también es una decisión razonable.
El coste que conviene evaluar para este uso es tu configuración completa: equipo disponible, espacio para los modelos, energía y tiempo de preparación. No publicamos un ganador por precio ni prometemos que ejecutar localmente salga más barato. Las condiciones y licencias de cada modelo requieren su propia revisión.
Qué elegir en cada caso
Empieza por LM Studio si tu prioridad es conversar con documentos en una aplicación y su compatibilidad encaja con tu ordenador. Valora Ollama si necesitas una integración que lo admita o prefieres su recorrido de uso. Si vas a desarrollar o automatizar, revisa las herramientas de ambos: LM Studio también tiene terminal y servidor independiente de la interfaz.
Para cualquiera de los dos, decide después de probar el mismo trabajo que harás a diario. El modelo, el contexto, la memoria y el destino local o de nube importan más que una etiqueta general de «más fácil», «más privado» o «más rápido» que esta revisión documental no ha medido.